Les données révèlent les dysfonctionnements de communication avant la rupture des échanges
Un dysfonctionnement de communication laisse rarement une trace unique. Il apparaît plutôt dans une combinaison d’indices : réponses qui s’allongent, messages non lus, tickets réouverts, baisse soudaine de l’engagement, erreurs de transmission ou activité inhabituelle sur un canal. La méthode consiste à comparer ces données à un fonctionnement attendu, puis à vérifier si l’écart révèle un incident, une incompréhension ou une évolution normale.
Repérer ce qui constitue réellement un dysfonctionnement
Une anomalie n’est pas automatiquement un problème. C’est d’abord un écart entre une observation et une base de référence : le niveau habituel de volume, de délai, de qualité ou d’interaction pour un canal, une équipe, un créneau horaire ou un type de destinataire. Une baisse des réponses peut être préoccupante un mardi matin, mais parfaitement logique pendant une fermeture annuelle ou après la fin d’une campagne.
Quiz : Détection des dysfonctionnements
Dans les communications internes comme dans les échanges clients, un dysfonctionnement peut concerner le contenu, le canal, la disponibilité d’un outil ou l’organisation du travail. Une information importante peut être envoyée mais peu consultée. Un ticket peut recevoir une réponse rapide mais incomplète. Un message peut être correctement rédigé tout en arrivant trop tard pour être utile. Les données rendent ces situations visibles, à condition de les lire avec leur contexte.
Trois formes d’anomalies à ne pas confondre
- L’anomalie ponctuelle correspond à une valeur isolée : une messagerie enregistre soudainement un taux exceptionnel de messages non délivrés ou un collaborateur accède à un volume inhabituel de conversations.
- L’anomalie contextuelle n’est anormale que dans une situation précise. Un fort volume de demandes au support peut être attendu après un lancement de produit, mais devenir un signal critique en période calme.
- L’anomalie collective apparaît lorsque plusieurs événements, anodins pris séparément, forment un motif préoccupant : délais de réponse qui augmentent, hausse des relances et baisse de la satisfaction sur le même parcours client.
Il faut aussi distinguer la rupture de la dérive. Une rupture est brutale, comme l’arrêt d’un flux de notifications après une mise à jour. Une dérive est progressive : au fil des semaines, les délais de traitement s’allongent ou un canal devient moins consulté. Cette différence détermine le niveau d’urgence et la nature de la correction.
Construire un jeu de données utile, sans surveiller les personnes
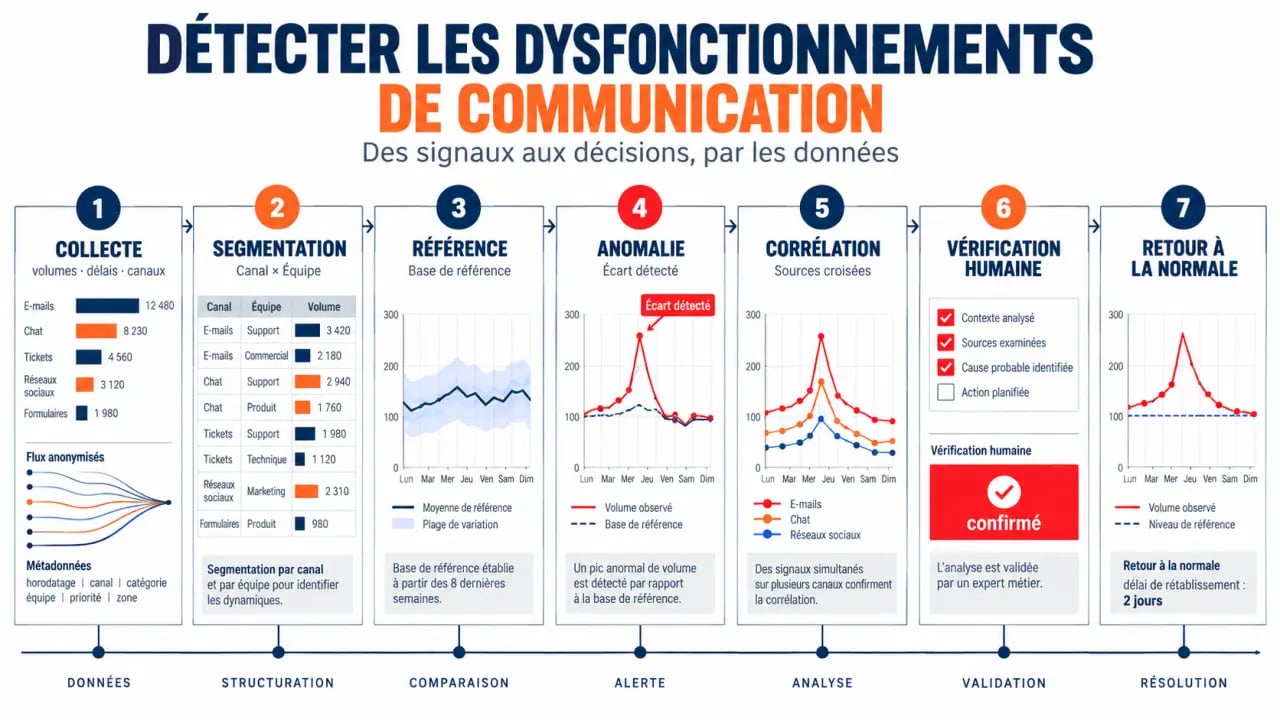
Pour détecter les dysfonctionnements de communication grâce aux données, commencez par collecter des informations mesurables et proportionnées à l’objectif. Les métadonnées sont souvent plus utiles que le contenu des messages : date et heure d’envoi, canal utilisé, délai de première réponse, nombre de relances, statut de livraison, résolution d’un ticket ou changement d’interlocuteur. Elles limitent aussi l’exposition aux données personnelles.
| Indicateur | Ce qu’il peut révéler | Source possible |
|---|---|---|
| Volume de messages ou de tickets | Rupture de flux, surcharge, baisse inhabituelle d’activité | Messagerie, CRM, centre de support |
| Délai de première réponse et de résolution | Goulot d’étranglement, manque de disponibilité, mauvaise orientation | Outil de support, agenda, plateforme collaborative |
| Taux de livraison, d’ouverture ou d’erreur | Problème technique, canal inadapté, perte d’information | Outil d’emailing, journaux applicatifs |
| Relances, réouvertures et transferts | Message incomplet, incompréhension ou traitement fragmenté | CRM, tickets, workflow |
| Connexions et trafic inhabituels | Accès suspect, exfiltration ou défaillance réseau | Journaux système, SIEM, EDR |
Segmenter avant de comparer
Une moyenne globale masque les écarts importants. Segmentez les données par canal, équipe, langue, fuseau horaire, type de demande ou catégorie de client. Le délai de réponse d’un service d’astreinte n’a pas le même sens que celui d’une équipe commerciale. De même, une campagne qui génère beaucoup de messages peut relever d’un fonctionnement normal, alors qu’un volume identique sur une messagerie administrative mérite une vérification.
Une communication efficace forme souvent une boucle mesurable : un émetteur transmet une information, le destinataire l’accuse réception, agit ou demande une précision, puis l’émetteur constate le résultat. Lorsque cette boucle se brise, l’indicateur le plus révélateur n’est pas toujours le volume d’envois, mais l’écart entre messages envoyés, réponses obtenues, actions réalisées et relances nécessaires. Suivre cette chaîne aide à détecter les pertes de sens, pas seulement les pannes techniques.
Choisir une méthode de détection adaptée à la maturité des données
La méthode la plus sophistiquée n’est pas systématiquement la meilleure. Une règle simple reste pertinente lorsqu’un comportement interdit ou critique est connu : absence de synchronisation depuis un délai défini, nombre excessif d’échecs de livraison ou connexion depuis un accès non autorisé. Les règles if-then sont lisibles, rapides à déployer et faciles à auditer, mais elles deviennent rigides face aux saisonnalités et aux changements d’usage.
Comprendre l’anonymisation des données personnelles : Découvrez les recommandations de la CNIL pour anonymiser et pseudonymiser les données personnelles conformément au RGPD.
| Méthode | À privilégier pour | Atout principal | Limite |
|---|---|---|---|
| Règles métier et seuils statiques | Incidents connus et contrôle opérationnel | Explicabilité immédiate | Nombreux faux positifs si le contexte varie |
| Statistiques et séries temporelles | Volumes, délais et tendances répétitives | Prise en compte de la saisonnalité | Moins adaptées aux relations complexes |
| Isolation Forest | Nombreuses variables sans incidents étiquetés | Isolation efficace des observations rares | Résultat à interpréter avec les métiers |
| DBSCAN | Groupes de comportements et densités atypiques | Repérage des points hors cluster | Sensible au réglage de densité |
| SVM à une classe | Apprentissage du comportement normal | Utile si les anomalies sont rares | Réglage délicat selon les données |
| Auto-encodeur | Données riches et relations non linéaires | Détection d’une erreur de reconstruction élevée | Exige davantage de données et d’expertise |
Supervisé, non supervisé ou semi-supervisé ?
L’apprentissage supervisé convient lorsqu’un historique fiable d’incidents qualifiés existe : fraude confirmée, erreur de routage identifiée ou violation validée. Les forêts aléatoires ou l’optimisation par gradients peuvent alors apprendre les caractéristiques des cas connus. L’apprentissage non supervisé est plus réaliste lorsque les anomalies sont inconnues ou peu documentées : il cherche les comportements inhabituels sans étiquette préalable. Le semi-supervisé combine les deux approches en apprenant surtout le fonctionnement normal avec quelques exemples d’incidents.
Transformer une alerte en diagnostic fiable
Une alerte doit ouvrir une enquête, non déclencher une conclusion automatique. Vérifiez d’abord la qualité de la donnée : doublon, changement de format, retard de chargement dans un pipeline ou erreur de mesure. Examinez ensuite les événements associés : mise à jour applicative, campagne de communication, réorganisation, incident réseau, changement de canal ou période saisonnière.
La corrélation multi-sources réduit les interprétations hâtives. Une hausse des délais de réponse accompagnée d’un pic de tickets, de journaux applicatifs montrant des erreurs et d’une baisse des connexions au portail suggère une cause technique. À l’inverse, des délais en hausse sans incident système, concentrés sur une équipe ou une langue, peuvent indiquer un problème de capacité, de procédure ou de clarté du message. En matière de sécurité, croisez les accès, le trafic réseau et les journaux système avant de suspecter un accès non autorisé.
Réduire les faux positifs et organiser la réponse
Des alertes trop nombreuses créent une fatigue d’alerte : les équipes finissent par ignorer les signaux réellement importants. Utilisez des seuils adaptatifs fondés sur les tendances et la saisonnalité, attribuez une criticité selon l’impact potentiel et exigez plusieurs indices concordants pour les alertes non urgentes. Une détection en temps réel est adaptée aux interruptions de service, aux accès suspects ou aux flux critiques. Une analyse par lot quotidienne ou hebdomadaire convient mieux aux dérives de qualité et aux tendances d’engagement.
Chaque alerte utile doit avoir un responsable, un délai de prise en charge et une action attendue. Documentez l’écart observé, l’hypothèse de cause, la vérification réalisée et la correction appliquée. Enfin, mesurez le retour à la normale avec les mêmes indicateurs : baisse des relances, rétablissement des délais, diminution des erreurs ou amélioration du taux de résolution. Cette traçabilité transforme la surveillance en démarche d’amélioration continue.
Mettre en place une surveillance responsable et durable
Un tableau de bord centralisé peut réunir les données de messagerie, CRM, support, journaux applicatifs et trafic réseau. Les outils d’observabilité, de gestion des logs, de SIEM ou d’analyse comportementale facilitent cette corrélation, mais ils ne remplacent ni la définition des objectifs ni la validation humaine. Commencez avec quelques indicateurs liés à un risque concret, puis enrichissez progressivement le dispositif.
La gouvernance est essentielle : limitez la collecte au nécessaire, privilégiez l’agrégation ou l’anonymisation lorsque cela suffit, contrôlez les droits d’accès et définissez une durée de conservation. Les données de communication servent à comprendre un processus et à prévenir un incident, non à instaurer une surveillance indiscriminée des individus. Un modèle explicable, des règles documentées et un circuit de validation clair renforcent à la fois la confiance et la qualité des décisions.